
Quando parliamo di preservazione in ambito software, il primo pensiero va inevitabilmente all’emulazione. Da decenni gli emulatori permettono di riprodurre intere piattaforme e di continuare a eseguire migliaia di programmi su hardware completamente diverso da quello per cui erano stati progettati.
OpenRecomp è un progetto che cerca un’altra strada. L’intento non è riprodurre via software l’hardware della vecchia macchina, ma ricompilare il software in modo che possa essere eseguito nativamente su hardware moderno.
Ovviamente non è un processo così automatico, anzi. Un vecchio binario contiene codice scritto per una determinata CPU, dipende da precise convenzioni, interagisce con memoria e hardware di quel sistema specifico. Far girare un vecchio software su hardware moderno potrebbe quindi portare a comportamenti che non esistevano, o non erano previsti, nel suo ambiente originale.
È qui che entra in gioco OpenRecomp, progetto sviluppato da Fred Day attorno al concetto di deterministic static recompilation. La pipeline trasforma il binario originale in una rappresentazione intermedia indipendente dall’architettura e da lì genera codice destinato alla macchina host. Per Fred, però, il risultato non è soddisfacente semplicemente perché l’esperimento “funziona”: deve poter essere verificato, riprodotto e confrontato con un riferimento. È uno dei principi fondamentali del progetto: la traduzione deve diventare un artefatto stabile, ispezionabile e verificabile, e il processo deve poter essere ripetuto indipendentemente.
Abbiamo parlato con lui proprio di questo: di architetture CPU differenti, indirect control flow, platform adapter, preservazione e soprattutto di ciò che dovrebbe accadere perché OpenRecomp possa un giorno smettere di essere solo un progetto di ricerca e diventare una vera piattaforma.
In questo momento OpenRecomp sta anche raccogliendo fondi per il prossimo passo del progetto: rafforzare il supporto MIPS32 e portarlo dallo stato CANDIDATE verso PROVEN attraverso sviluppo, validazione, test riproducibili e documentazione pubblica. La campagna è attiva su Crowdfunder, con un obiettivo di 10.500 sterline e formula all or nothing.
Sostieni la campagna OpenRecomp MIPS32
OpenRecomp è costruito attorno alla deterministic static recompilation. Per i lettori più abituati all’emulazione tradizionale, cosa significa “deterministic” in questo contesto e perché è importante per il modo in cui vuoi che il progetto venga testato e considerato affidabile?
In OpenRecomp, “deterministic” si riferisce principalmente alla pipeline di traduzione, non al comportamento del programma guest in sé. Un programma ricompilato può comunque utilizzare casualità, timing o input esterni come qualsiasi altro programma.
Ciò che voglio sia deterministico è la trasformazione dal binario originale alla rappresentazione intermedia di OpenRecomp e successivamente al codice lato host. Dato lo stesso binario di input, gli stessi contratti e la stessa toolchain definita, la pipeline dovrebbe produrre la stessa traduzione invece di prendere decisioni di traduzione dinamicamente durante l’esecuzione del programma.
Questo è importante perché rende le prove riproducibili. Invece di dire “l’ho eseguito e sembrava corretto”, posso dire: eseguite questo input attraverso questa pipeline, eseguite il risultato confrontandolo con questo riferimento, raccogliete queste osservazioni e confrontatele. Un’altra persona dovrebbe poter ripetere indipendentemente quel processo e ottenere lo stesso risultato.
Naturalmente anche un emulatore basato su JIT può essere deterministico ed estremamente accurato. La differenza è che OpenRecomp mira a rendere la traduzione stessa un artefatto stabile, che possa essere ispezionato, versionato e verificato prima dell’esecuzione. È questo che permette di costruire fiducia attraverso prove riproducibili, invece che soltanto attraverso una quantità crescente di play-testing.
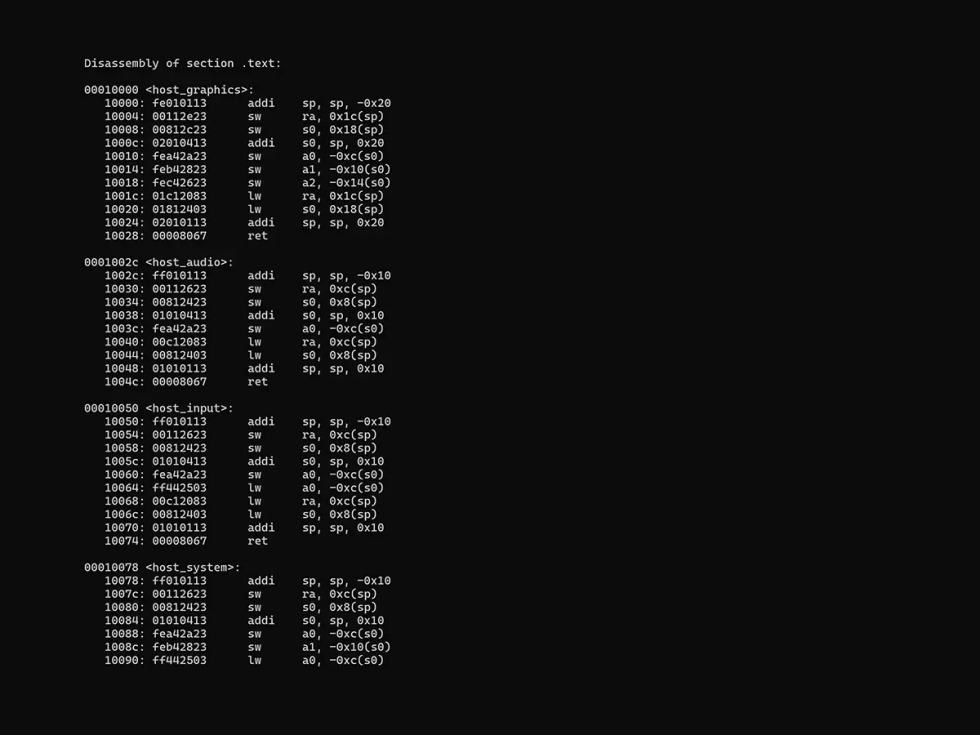
Una delle idee centrali di OpenRecomp è che diverse architetture guest possano confluire in una rappresentazione intermedia comune. Dove tracci il confine tra ciò che può essere realmente condiviso tra architetture e ciò che inevitabilmente rimarrà specifico di una CPU, di una piattaforma o persino di un singolo software?
Io la considero una struttura composta da tre livelli.
Il core condiviso contiene la struttura della pipeline, la rappresentazione intermedia, la rappresentazione del control flow, le operazioni sulla memoria, la validazione dei contratti, la generazione del codice host e i meccanismi relativi alle prove. Questo livello non dovrebbe avere bisogno di sapere se il programma originale proviene da MIPS32, RV32I o da una futura architettura.
Il comportamento specifico dell’architettura appartiene invece al frontend. Codifica delle istruzioni, registri, endianness, calling convention, delay slot, flag e altre regole specifiche della CPU devono essere tradotti in semantiche IR generiche ed esplicite. Un delay slot MIPS, per esempio, dovrebbe diventare una sequenza esplicita di operazioni nell’IR, in modo che il backend non abbia bisogno di sapere che i delay slot MIPS esistono.
Poi esiste un terzo livello che non è né completamente legato all’architettura né completamente generico: il comportamento specifico del software. Un compilatore può organizzare una jump table in modo insolito, un programma può dipendere da una particolarità non documentata oppure utilizzare codice automodificante. Nessuna rappresentazione intermedia fa semplicemente sparire questi problemi.
L’obiettivo, quindi, non è fingere che tutto possa diventare indipendente dall’architettura. È mantenere condiviso ciò che può esserlo realmente, spostare la semantica specifica della CPU nei frontend e mantenere gli eventuali residui specifici del software quanto più piccoli e chiaramente delimitati possibile.
Dai molta importanza alle prove e alla distinzione tra risultati CANDIDATE e PROVEN. Cosa deve dimostrare un risultato prima che tu possa considerarlo realmente PROVEN e come eviti che un recompiler produca qualcosa che appare corretto ma fallisce in casi meno evidenti?
Uso CANDIDATE e PROVEN come descrizioni della forza delle prove, non come etichette che indicano quanto sia avanzata l’implementazione.
Un risultato può compilare, essere eseguito e apparire corretto, rimanendo comunque CANDIDATE se l’affermazione non è ancora stata verificata indipendentemente rispetto a un contratto definito. PROVEN significa che posso indicare con precisione quale affermazione viene fatta, quali prove la supportano e un processo di verifica riproducibile che non dipenda dalla mia interpretazione del risultato.
Quando possibile, questo include un confronto del comportamento tra un percorso di riferimento e l’esecuzione nativa generata: registri, stato della memoria, valori restituiti, checksum o altri stati osservabili dall’esterno rilevanti per il test.
Il punto importante è che un PASS, da solo, non è sufficiente. Voglio testare anche i punti in cui la pipeline dovrebbe fallire: input malformati, comportamenti fuori dai limiti, assunzioni non più valide, controlli di integrità e casi nei quali due percorsi di esecuzione teoricamente equivalenti non concordano.
Questo approccio si è già rivelato importante in OpenRecomp. L’audit della pipeline ha individuato problemi che non sarebbero emersi in una dimostrazione limitata all’happy path, incluse assunzioni sulla validazione o sui limiti che erano più deboli di quanto apparissero. Se in seguito le prove dimostrano che un’affermazione non raggiunge il livello che inizialmente le avevo attribuito, preferisco declassificarla piuttosto che proteggere l’etichetta.
Per me, la disponibilità a far retrocedere un risultato oltre che a farlo avanzare è parte di ciò che rende utile questa classificazione delle prove.
Hai individuato nell’indirect control flow uno dei maggiori ostacoli nel passaggio dalle fixture sintetiche al software reale. Perché jump table, function pointer e computed branch sono particolarmente difficili per un recompiler statico e quale tipo di soluzione pensi che OpenRecomp dovrà adottare?
Un branch o una call diretti dicono al recompiler dove proseguirà l’esecuzione. Un branch indiretto no. La destinazione può provenire da un registro, dalla consultazione di una tabella, da un function pointer o da uno slot di una funzione virtuale e potrebbe diventare nota soltanto durante l’esecuzione.
Questo rompe una delle assunzioni più utili della static recompilation: poter costruire completamente il control-flow graph del programma prima che il programma venga eseguito.
Un emulatore aggira naturalmente questo problema perché il codice guest originale rimane disponibile. Se l’esecuzione salta all’indirizzo X, l’emulatore può semplicemente decodificare ciò che si trova all’indirizzo X. Un recompiler statico non può dare per scontato che questa rete di sicurezza esista. Se ha sostituito il programma originale con codice host tradotto, deve sapere che ogni destinazione legittima possiede una controparte tradotta.
Mi aspetto che la soluzione abbia almeno due componenti.
La prima consiste nel recuperare staticamente quanto più possibile. I compilatori tendono a produrre strutture riconoscibili per switch table, vtable e altre forme di indirect control flow, quindi una parte significativa potrebbe potenzialmente essere risolta in anticipo.
Per le destinazioni che rimangono realmente dinamiche, mi aspetto che OpenRecomp abbia bisogno di qualche meccanismo limitato di runtime dispatch capace di associare gli indirizzi guest conosciuti alle rispettive funzioni host tradotte.
La questione progettuale importante riguarda ciò che accade quando una destinazione non è presente in quella mappa. Attualmente preferirei che quel caso fallisse esplicitamente, invece di ricorrere silenziosamente a un’esecuzione arbitraria. Non voglio che un interprete general-purpose diventi una rete di sicurezza nascosta, perché questo finirebbe progressivamente per indebolire il modello di static recompilation che il progetto sta cercando di verificare.
Anche con una ricompilazione corretta della CPU, una console storica porta con sé grafica, audio, interrupt, DMA, timing e molti altri comportamenti hardware. Come immagini che i platform adapter di OpenRecomp possano gestire questo confine senza trasformare il core del progetto in un emulatore diverso per ogni macchina?
Voglio che la ricompilazione della CPU e il comportamento della piattaforma si incontrino attraverso un confine molto rigido.
Il core dovrebbe comprendere la semantica della CPU. Un platform adapter dovrebbe comprendere l’ambiente con cui quella CPU si aspettava di comunicare.
Quando si va oltre il processore, un programma per una console reale interagisce con registri memory-mapped, flussi di comandi grafici, DMA, interrupt, sistemi audio, timer e altro hardware dotato di stato. Alcune di queste interazioni possono essere mappate in maniera relativamente semplice sulle API moderne; altre potrebbero richiedere una modellazione molto più profonda.
La regola architetturale importante è che questi dettagli non ritornino all’interno del core di ricompilazione indipendente dall’architettura.
Un platform adapter, quindi, non significa necessariamente che ogni scrittura verso l’hardware diventi una semplice chiamata API. Potrebbe essere necessario mantenere una quantità considerevole di stato relativo alla piattaforma. Ma questa complessità dovrebbe rimanere fuori dal traduttore principale.
Una direzione che ho già esplorato consiste nel reindirizzare il comportamento rivolto all’hardware verso un runtime moderno invece di ricreare il silicio originale all’interno del recompiler. In questo modello, la logica CPU tradotta rimane codice nativo, mentre il platform layer traduce le operazioni rilevanti destinate all’hardware nei servizi forniti dall’ambiente host.
L’equilibrio preciso varierà molto da una piattaforma all’altra, ma questa separazione è importante: OpenRecomp non dovrebbe essere costretto a diventare un recompiler CPU diverso ogni volta che viene presa di mira una console differente.
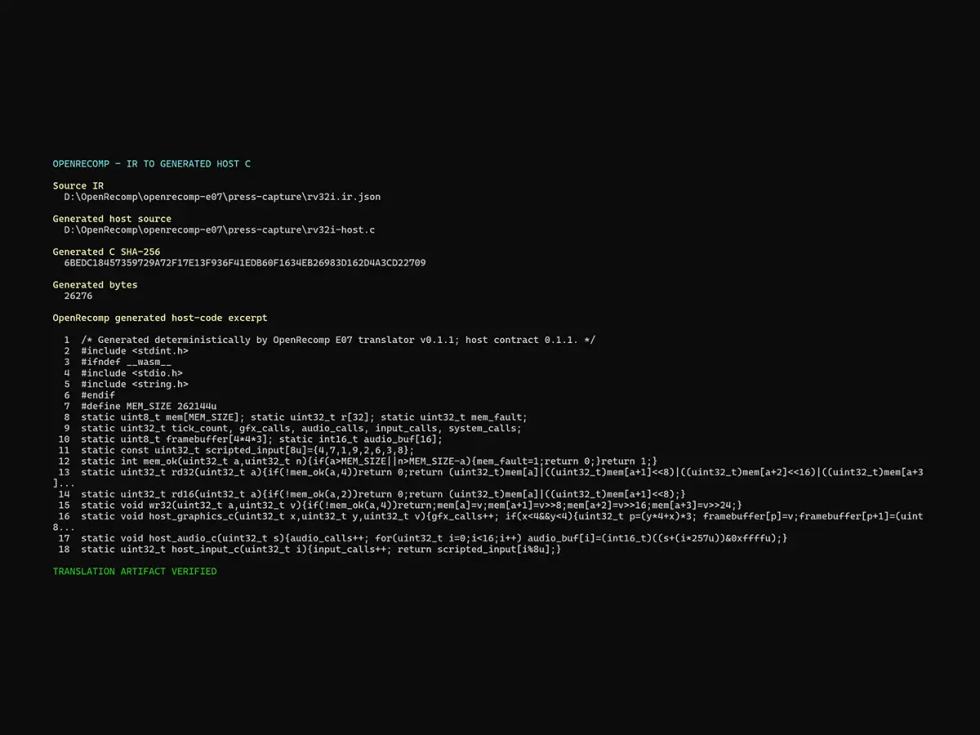
Il prossimo grande traguardo che hai descritto consiste nel portare un piccolo programma MIPS reale e distribuibile legalmente attraverso l’intera pipeline. Cosa rappresenterebbe per te una dimostrazione riuscita? Arrivare semplicemente all’esecuzione nativa sarebbe sufficiente oppure vorresti confronti comportamentali riproducibili simili alle prove che stai producendo oggi?
L’esecuzione nativa sarebbe necessaria, ma non sarebbe sufficiente.
Se un vero binario MIPS arriva fino a diventare un eseguibile Windows e comincia a funzionare, questo dimostra che la pipeline non è fallita immediatamente. Non dimostra che la traduzione sia corretta.
La dimostrazione che voglio ottenere consiste in un piccolo binario MIPS distribuibile legalmente, che non sia stato scritto specificamente per OpenRecomp, portato attraverso l’ingestione del binario, la traduzione del frontend, l’IR comune, la generazione AOT del codice e infine l’esecuzione nativa.
A quel punto voglio confrontare il comportamento osservabile significativo del risultato nativo con un riferimento definito. A seconda del programma, questo potrebbe significare valori restituiti, stato dei registri, contenuto della memoria, buffer generati, hash oppure altri output deterministici.
Soprattutto, il processo dovrebbe essere riproducibile da qualcuno che non sia io.
Il vero passo avanti, quindi, non sarebbe “OpenRecomp ha eseguito un binario MIPS”. Sarebbe: “OpenRecomp ha eseguito un vero binario MIPS prodotto indipendentemente ed esistono prove riproducibili che il comportamento tradotto concordi con quello di riferimento entro un ambito chiaramente definito”.
Questo rappresenterebbe una prova molto più forte rispetto a un altro test sintetico, perché il programma reale sarebbe stato prodotto da una normale toolchain e non sarebbe stato progettato specificamente per rendere più semplice il lavoro del recompiler.
Dal punto di vista della preservazione, cosa può offrire potenzialmente la static recompilation che l’emulazione tradizionale già non faccia molto bene? Consideri OpenRecomp principalmente un altro modo per mantenere eseguibile il vecchio software oppure potrebbe, in futuro, affrontare problemi di preservazione che la sola emulazione non riesce a risolvere?
L’emulazione è già una delle tecnologie di preservazione di maggior successo che abbiamo e non considero OpenRecomp un suo sostituto.
Un buon emulatore può preservare un’intera piattaforma hardware e migliaia di software. La static recompilation, soprattutto quando singoli titoli richiedono del lavoro specifico sulla piattaforma, difficilmente potrà raggiungere quella stessa ampiezza e non dovrebbe cercare di farlo.
Ciò che la ricompilazione può potenzialmente offrire è un compromesso diverso per determinati software, quando l’ulteriore lavoro ingegneristico necessario è giustificato.
Un artefatto ricompilato può dipendere meno direttamente dalla continua riproduzione dell’ambiente hardware originale. Il codice host generato potrebbe potenzialmente essere ricostruito utilizzando toolchain future, esaminato con normali strumenti di sviluppo e collegato deliberatamente alle moderne API host.
Questo potrebbe rendere determinati programmi più facili da mantenere o adattare nel corso di periodi molto lunghi, mentre l’emulazione rimane la risposta più forte per la compatibilità su intere librerie e per una preservazione accurata della macchina originale.
Possono inoltre esistere modelli legali e distributivi utili nei quali i binari o gli asset originali protetti da copyright non vengono redistribuiti e l’utente finale fornisce autonomamente il proprio materiale ottenuto legalmente.
Vedo quindi i due approcci come complementari, non come concorrenti.
Per dirlo nel modo più semplice: l’emulazione preserva la macchina; la static recompilation può offrire un altro modo per preservare specifici software.
Guardando ancora più avanti, cosa ti porterebbe a considerare OpenRecomp un progetto maturo invece di un esperimento di ricerca? Esiste un particolare traguardo tecnico o un caso d’uso reale che ti farebbe dire che l’idea alla base del progetto ha realmente funzionato?
Smetterei di considerare OpenRecomp principalmente un progetto sperimentale di ricerca quando qualcun altro, oltre a me, sarà in grado di prendere il framework, aggiungere il supporto per un’architettura o una piattaforma che non ho sviluppato personalmente, portare un programma reale attraverso l’intera catena delle prove e produrre un risultato riproducibile indipendentemente senza aver bisogno che io guidi ogni fase.
Un singolo programma reale eseguito con successo dimostrerebbe che l’idea può funzionare.
La maturità richiede più di una singola dimostrazione. Vorrei vedere uno storico di risultati: diversi programmi reali, idealmente distribuiti su più di un’architettura guest, build riproducibili, contratti ben definiti, limitazioni note dichiarate esplicitamente e una documentazione sufficiente affinché il progetto possa continuare senza dipendere dal suo autore originale.
Un gioco commerciale eseguito con successo attraverso la pipeline sarebbe ovviamente un traguardo importante, ma non penso che una singola dimostrazione spettacolare possa, da sola, provare la neutralità rispetto all’architettura o la maturità del progetto.
Il test più profondo è la ripetibilità.
Un risultato notevole è una prova. Un processo ripetibile è una piattaforma.
───────────────────────────────────────────
È forse proprio quest’ultima frase a spiegare meglio di qualsiasi definizione cosa Fred Day stia cercando di costruire.
OpenRecomp è ancora un progetto in evoluzione e il percorso verso software reale, architetture differenti e piattaforme complete presenta problemi di cui Fred stesso non fa mistero. Anzi, la distinzione tra ciò che è già dimostrato e ciò che rimane ancora da dimostrare è una parte fondamentale del progetto.
Ed è anche ciò che lo rende interessante.
La static recompilation non ha la pretesa di sostituire gli emulatori, né avrebbe senso pensare di farlo. Un emulatore continua ad avere un vantaggio enorme quando l’obiettivo è preservare un’intera macchina e il suo catalogo. OpenRecomp cerca di intraprendere una strada diversa, vuole capire fino a che punto sia possibile rendere indipendente un vecchio programma dall’hardware per cui era stato scritto, tradurlo in modo verificabile e farlo girare su macchine moderne.
Oggi il prossimo passo è portare un piccolo programma MIPS reale, distribuibile legalmente e non scritto appositamente per OpenRecomp, attraverso l’intera pipeline fino all’esecuzione nativa. Ma l’obiettivo sarà ottenere risultati concreti e, soprattutto, fare in modo che qualcun altro riesca a ripeterli senza l’ausilio di Fred. Sarà questo a dirci quanto lontano questa idea possa spingersi.
Memorie dei lettori
Commenti, ricordi e punti di vista restano qui, accanto all’articolo.
Regolamento commentiAccedi o registrati per lasciare un commento.
Lascia un commento
Crea il tuo account
Caricamento commenti...